Почему «звучит убедительно» ≠ «правильно»
Нейросети пишут гладко, уверенно и без пауз — и именно поэтому им легко поверить на слово. Но убедительный тон никак не связан с фактической правотой: модель одинаково ровно формулирует и проверенный факт, и выдуманную цифру. Чтобы понять, как оценивать качество ответов ИИ, придётся отделить форму от содержания и завести собственные критерии — не «нравится / не нравится», а измеримые признаки. В этом гайде разберём семь метрик, приёмы против галлюцинаций и два копируемых чек-листа: быстрый на 60 секунд и глубокий для приёмки контента. Если вы только начинаете, сперва загляните в базовый гайд по работе с нейросетями — там про то, как вообще формулировать запросы, а здесь мы уже проверяем результат. Отдельно оговоримся: иногда плохой ответ — это не про качество модели, а про то, что нейросеть просто не работает из-за сбоя или ограничений доступа.
Кстати, оценивать качество проще, когда один и тот же вопрос можно за минуту прогнать через несколько нейросетей и сравнить ответы рядом. В Zerocoder они собраны в одном рабочем окне — доступ из России без VPN, оплата российскими картами, а при регистрации дают бесплатные кредиты, чтобы потестировать на своих задачах.
Эффект уверенного тона и почему он опасен
Языковые модели обучены звучать естественно и авторитетно — это часть их работы. Проблема в том, что уверенность интонации не масштабируется вместе с достоверностью. Модель напишет «согласно исследованию 2023 года…» с той же лёгкостью, с какой сошлётся на реальный источник, — разницы в тоне вы не услышите. Психологически мы склонны доверять беглой, структурированной речи: если текст без запинок и с цифрами, мозг ставит галочку «эксперт». Это когнитивная ловушка. Практический вывод простой: не позволяйте форме ответа влиять на оценку его содержания. Хороший приём — мысленно переписать ответ сухими тезисами без прилагательных. Если после этого утверждения выглядят голословно, значит, вас впечатлил стиль, а не суть.
Что вообще значит «качество» ответа
Качество — это не абстрактная «хорошесть», а совпадение результата с вашей задачей по нескольким осям одновременно. Ответ может быть фактически верным, но не по теме. Или релевантным, но неполным. Или полным, но с выдуманной ссылкой в конце. Поэтому оценивать по одному критерию бессмысленно — нужна система из нескольких измеримых признаков, каждый из которых можно проверить отдельно. Ниже разложим качество на семь таких признаков и покажем на примерах «плохой ответ → что не так → как проверил». Это превратит расплывчатое ощущение «что-то не то» в конкретный список претензий, который можно предъявить модели и попросить исправить.
7 метрик качества ответа ИИ
Качество ответа ИИ оценивают по семи измеримым признакам: точность, релевантность, полнота, структура, отсутствие галлюцинаций, воспроизводимость и соответствие заданным ограничениям. Каждый из них проверяется отдельным вопросом к тексту, и вместе они дают объёмную картину вместо интуитивного «нравится». Точность отвечает на вопрос «это правда?», релевантность — «это про то, что я спрашивал?», полнота — «всё ли важное учтено?», структура — «удобно ли это читать и использовать?». Отсутствие галлюцинаций проверяет, не выдуманы ли факты, цифры и источники. Воспроизводимость показывает, стабилен ли ответ при повторе. Соответствие ограничениям следит за форматом, длиной и тоном. Ниже — по каждой метрике короткий разбор с примером и способом проверки. Держите их в голове как чек-бокс: не обязательно каждый раз прогонять все семь, но при важных решениях стоит пройтись по всему списку.
Точность (фактическая корректность)
Точность — это соответствие утверждений реальности. Плохой пример: «Столица Австралии — Сидней». Что не так: Сидней крупнейший город, но столица — Канберра. Как проверил: сверил спорный факт с независимым источником за 20 секунд. Проверяйте в первую очередь то, что легко перепутать, — даты, имена, цифры, географию, юридические нормы. Если модель приводит статистику, требуйте конкретики: «какого года данные и кто их собрал?». Расплывчатое «по некоторым оценкам» — сигнал, что цифра могла быть додумана.
Релевантность запросу
Релевантность — насколько ответ отвечает именно на ваш вопрос, а не на соседний. Плохой пример: вы спросили «как снизить отток клиентов в SaaS», а получили общий текст про важность клиентского сервиса. Что не так: ответ верный, но не операбельный, без привязки к SaaS и оттоку. Как проверил: перечитал свой промпт и отметил, на какие его части модель не ответила. Если релевантность страдает, чаще виноват размытый запрос — сузьте контекст, добавьте роль и ограничения.
Полнота
Полнота — учтены ли все существенные аспекты. Ответ может быть верным и по теме, но упускать половину картины. Хороший способ проверить полноту пересказа или конспекта — сжать исходник самому и сравнить, что модель выкинула. Инструменты вроде краткого содержания текста удобны как раз для этого: прогоняете длинный документ, а потом сверяете, не потерялись ли ключевые тезисы, цифры и выводы. Если в пересказе пропал важный нюанс — полнота нарушена, даже если всё остальное безупречно.
Структура и читаемость
Структура — насколько удобно ответ читать и использовать дальше. Стена текста без абзацев, где вывод спрятан в середине, — это низкое качество, даже если факты верны. Хороший ответ имеет логичную последовательность: тезис, обоснование, вывод; списки там, где перечисление; таблица там, где сравнение. Проверка простая: можете ли вы за пять секунд найти в ответе главное? Если приходится вычитывать весь текст, чтобы выудить суть, попросите модель переформатировать — вынести вывод в начало и структурировать по пунктам.
Отсутствие галлюцинаций / выдуманных источников
Галлюцинация — уверенно поданный, но выдуманный факт, источник или цифра. Классика жанра: модель приводит «ссылку на исследование» с правдоподобным названием журнала и годом, которого не существует. Что не так: источник сфабрикован, хотя выглядит академично. Как проверил: попробовал найти работу по названию — её нет. Выдуманные ссылки, несуществующие функции API, цитаты, которых автор не говорил, — самые опасные ошибки, потому что маскируются под достоверность. Ниже отдельный раздел про то, как их системно ловить.
Воспроизводимость (стабильность при повторе)
Воспроизводимость — даёт ли модель схожий по сути ответ на один и тот же запрос при повторе. Если два прогона одного промпта противоречат друг другу (в одном «да», в другом «нет»), доверять нельзя ни одному. Проверка: задайте важный вопрос 2–3 раза, желательно в новых чатах. Совпадают выводы — хорошо; расходятся — сигнал, что модель не «знает» ответ, а угадывает. Для критичных задач фиксируйте формулировку промпта: чем он конкретнее, тем стабильнее результат.
Соответствие ограничениям (формат, длина, тон)
Соответствие ограничениям — выполнил ли ответ технические условия задания. Вы просили список из пяти пунктов до 100 слов в деловом тоне — а получили три абзаца эссе. Формально текст может быть хорошим, но он не годится: не встанет в шаблон, не влезет в поле, не подойдёт по стилю. Проверка механическая: пройдитесь по своим требованиям как по чек-листу — формат, длина, тон, язык, наличие обязательных элементов. Несоблюдение ограничений — самая дешёвая в исправлении ошибка: обычно достаточно переспросить строже.
Как ловить галлюцинации: практические приёмы
Галлюцинация — это уверенно поданный, но выдуманный факт, источник или цифра. Распознать её помогают три приёма: проверка источников по первоисточнику, «перекрёстный допрос» тем же вопросом в другой формулировке и внимание к красным флагам в самом тексте. Ключевая идея: галлюцинации почти всегда живут в деталях, которые звучат конкретно, но которые лень проверять, — точные проценты, названия исследований, номера статей закона, версии функций. Чем правдоподобнее и специфичнее деталь, тем важнее её сверить, потому что именно такие фрагменты модель склонна «дорисовывать» для убедительности. Не пытайтесь проверять всё подряд — это неэффективно. Выделяйте утверждения, на которых вы будете принимать решение или которые пойдут в публикацию, и проверяйте в первую очередь их. Остальное можно оставить на уровне здравого смысла. Ниже — как это делать быстро и без паранойи.
Проверка источников и ссылок
Если модель ссылается на источник, отнеситесь к ссылке как к гипотезе, а не как к факту. Реальная ссылка открывается и содержит именно то, что заявлено; выдуманная либо не открывается, либо ведёт на страницу, где нужного утверждения нет. Проверка источников в ответе ИИ занимает минуту: скопируйте название работы или цитату в поисковик. Нет совпадений — почти наверняка галлюцинация. Отдельно проверяйте цифры: попросите модель назвать, откуда взята статистика, и если ответ «из общих знаний» — считайте цифру неподтверждённой.
«Перекрёстный допрос» — переспросить иначе
Задайте тот же вопрос по-другому, с другой стороны, и сравните ответы. Если модель уверена в факте, формулировка не изменит суть; если она угадывала, ответы разойдутся. Второй вариант приёма — попросить модель самой оспорить свой ответ: «перечисли, что в этом утверждении может быть неверным». Полезно и обратное сжатие: прогнать длинный ответ через конспект нейросетью, а затем спросить, откуда взялся каждый ключевой тезис. Когда факты вынуты из обёртки красивого текста, слабые места видны сразу.
Красные флаги в тексте
Некоторые признаки почти всегда указывают на риск галлюцинации. Держите их перед глазами:
- Сверхточные цифры без источника — «эффективность выросла на 37,4%», но откуда — молчок.
- Круглые «удобные» проценты — «в 80% случаев», когда явно неоткуда взяться замеру.
- Названия исследований и авторов, которые нельзя нагуглить.
- Ссылки на «свежие данные» за пределами периода обучения модели.
- Чрезмерная категоричность в спорной теме — «однозначно доказано, что…».
- Несуществующие функции или методы в коде и инструкциях.
Чек-лист быстрой проверки (за 60 секунд)
Быстрая проверка нужна, когда ответ не пойдёт в публикацию и не станет основой важного решения, но убедиться в вменяемости всё равно надо. Она укладывается в минуту и состоит из шести вопросов к тексту. Смысл в том, чтобы поймать грубые ошибки и явные галлюцинации, не углубляясь в полноценный фактчекинг. Если ответ проходит все шесть пунктов — им можно пользоваться с обычной осторожностью. Если спотыкается хотя бы на одном критичном (точность или выдуманный источник) — либо переспросите модель строже, либо перепроверьте вручную, либо прогоните тот же промпт через другую нейросеть. Этот чек-лист удобно держать закреплённым рядом с рабочим окном и проходить его автоматически, почти не задумываясь. Ниже — копируемая версия, которую можно сохранить в заметки и использовать как рубрику для любой команды.
- По теме? Ответ отвечает именно на мой вопрос, а не на соседний.
- Факты не вызывают сомнений? Нет очевидно спорных дат, цифр, имён.
- Источники реальны? Если есть ссылки — хотя бы одна проверена.
- Ничего важного не упущено? Основные аспекты вопроса закрыты.
- Формат соблюдён? Длина, структура и тон соответствуют запросу.
- Нет красных флагов? Никаких «удобных» процентов без источника.
Чек-лист глубокой приёмки (для контента и бизнес-задач)
Глубокая приёмка нужна, когда ответ ИИ пойдёт в публикацию, в отчёт для клиента, в код продакшена или ляжет в основу решения с деньгами и репутацией. Здесь недостаточно «выглядит нормально» — нужен пройденный по пунктам аудит по всем семи метрикам плюс проверка на соответствие вашим внутренним требованиям. Такой чек-лист занимает от нескольких минут до получаса в зависимости от объёма, зато защищает от дорогих ошибок: выдуманной статистики в публичной статье, несуществующего метода в коде, юридически неверной формулировки в договоре. Заведите его как обязательный этап и не пропускайте, даже когда ответ кажется идеальным, — именно идеально звучащие тексты чаще всего содержат замаскированные галлюцинации. Ниже — расширенная версия, которую стоит адаптировать под свой тип задач и закрепить как стандарт приёмки для всей команды.
- Фактчекинг. Каждое утверждение, влияющее на решение, сверено с первоисточником.
- Источники. Все ссылки открываются и подтверждают заявленное; выдуманные удалены.
- Цифры. У каждой статистики есть год и происхождение; неподтверждённое помечено.
- Полнота. Сверено с исходником или брифом — ничего существенного не потеряно.
- Релевантность. Ответ решает именно поставленную задачу, без воды.
- Тон и стиль. Соответствует бренд-гайду / целевой аудитории.
- Формат. Структура, длина, обязательные элементы на месте.
- Оригинальность. Нет копипаста и клише; для кода — нет чужих лицензий втихую.
- Воспроизводимость. Спорные выводы перепроверены повторным прогоном.
- Второе мнение. Критичный ответ прогнан через другую модель для сверки.
Как сравнивать ответы разных нейросетей объективно
Чтобы сравнить нейросети объективно, задайте один и тот же промпт нескольким моделям и оцените ответы по рубрике 0–2 балла за каждую метрику. Субъективное «этот ответ мне больше нравится» ничего не даёт — нужна воспроизводимая процедура, где каждая модель проходит один и тот же тест в одинаковых условиях. Три вещи делают сравнение честным: идентичный промпт для всех, единая шкала оценки и, по возможности, эталон правильного ответа (ground truth), с которым можно сверять. Такой подход убирает эффект «первое впечатление» и показывает, какая модель стабильно сильнее именно на ваших задачах, а не в абстрактных бенчмарках. Удобнее всего проводить сравнение, когда модели открыты в одном окне и промпт можно продублировать в пару кликов, — тогда вы не тратите время на переключение вкладок и ручное копирование. Ниже — как выстроить такое сравнение по шагам.
Один промпт → несколько моделей
Возьмите реальную задачу из вашей практики, а не искусственный тест. Сформулируйте промпт максимально конкретно и зафиксируйте его дословно — одинаковый текст для всех моделей. Доступ к разным моделям, включая ChatGPT и другие семейства, удобно получить через единое окно, где не нужно заводить отдельные аккаунты и подписки. Прогоните промпт, соберите ответы в таблицу по колонкам и только потом переходите к оценке — так вы сравниваете содержание, а не порядок, в котором читали.
Простая рубрика-оценка 0–2 балла
Оценивайте каждый ответ по метрикам, выставляя за пункт 0 (не выполнено), 1 (частично), 2 (полностью). Так «нравится» превращается в число, которое можно сравнить.
| Метрика | Модель A | Модель B | Модель C |
|---|---|---|---|
| Точность | 2 | 1 | 2 |
| Релевантность | 2 | 2 | 1 |
| Полнота | 1 | 2 | 1 |
| Структура | 2 | 1 | 2 |
| Без галлюцинаций | 2 | 1 | 2 |
| Итого (из 10) | 9 | 7 | 8 |
Ground truth: когда он нужен и где взять
Ground truth — эталонный правильный ответ, с которым сверяют результат модели. Он нужен там, где есть однозначная истина: расчёты, факты, извлечение данных, код с ожидаемым выводом. Где взять: возьмите задачу, ответ на которую вы уже точно знаете (готовый отчёт, проверенный документ, тест с известным результатом), и подайте её модели как новую. Совпало с эталоном — плюс балл к доверию. Для творческих и открытых задач жёсткого ground truth нет — там опирайтесь на рубрику и экспертную оценку.
Пошагово: как выстроить свою систему оценки
Собственная система оценки строится в пять шагов и превращает разрозненные проверки в повторяемый процесс, который не зависит от настроения и памяти. Смысл системы — чтобы любой человек в команде оценивал ответы по одним и тем же правилам и получал сопоставимые результаты. Начинается всё с определения, что для вас «качество» в конкретном классе задач, а заканчивается регулярным пересмотром критериев по мере накопления примеров. Не пытайтесь построить идеальную систему сразу — начните с быстрого чек-листа и одной рубрики, а детали добавляйте по мере того, как ловите типовые ошибки. Отдельно стоит прокачать сами промпты: чем точнее запрос, тем меньше проверок нужно на выходе. Если хотите разобраться в этом системно, помогает курс промпт-инжиниринга — он как раз про то, как формулировать так, чтобы результат было легко оценивать. Ниже — конкретные шаги.
- Определите, что такое «хорошо». Для каждого типа задач выпишите 3–5 критериев, по которым будете судить об ответе.
- Соберите рубрику. Переведите критерии в шкалу 0–2 балла, чтобы оценка была числом, а не мнением.
- Заведите набор эталонных задач. 5–10 реальных кейсов с известным правильным ответом для регулярного тестирования.
- Проверьте на нескольких моделях. Прогоняйте эталоны через разные нейросети и фиксируйте баллы в таблице.
- Закрепите чек-лист приёмки. Сделайте его обязательным этапом перед публикацией или внедрением.
- Пересматривайте. Раз в месяц добавляйте новые красные флаги из пойманных ошибок.
Частые ошибки при оценке ответов ИИ
Самые частые ошибки при оценке ответов ИИ связаны не с моделями, а с самими проверяющими: мы доверяем тону, ленимся сверять источники и оцениваем по единственному критерию. Ещё одна ловушка — проверять всё подряд одинаково тщательно, из-за чего проверка становится слишком дорогой и её перестают делать вовсе. Правильный подход — калибровать глубину проверки под цену ошибки: черновик для себя и юридический документ требуют разного уровня контроля. Многие также забывают про воспроизводимость и делают выводы по одному прогону, хотя следующий ответ может противоречить первому. Наконец, распространённая ошибка — оценивать в вакууме, без эталона и без сравнения с другой моделью, когда «нормально» не с чем сопоставить. Если оценка качества становится системной задачей для команды, её настройку разумно отдать специалисту — можно нанять специалиста по промпт-инжинирингу, который выстроит рубрики и процесс приёмки под ваши задачи.
- Верить тону. Убедительность ≠ правота — переписывайте ответ сухими тезисами.
- Один критерий. Оценка только «по фактам» пропускает провалы в полноте и релевантности.
- Не сверять источники. Ссылки и цифры принимаются на веру — главный путь к галлюцинациям.
- Один прогон. Игнорирование воспроизводимости даёт ложную уверенность.
- Равная глубина для всего. Тратить час на черновик и минуту на договор.
Метрики под тип задачи
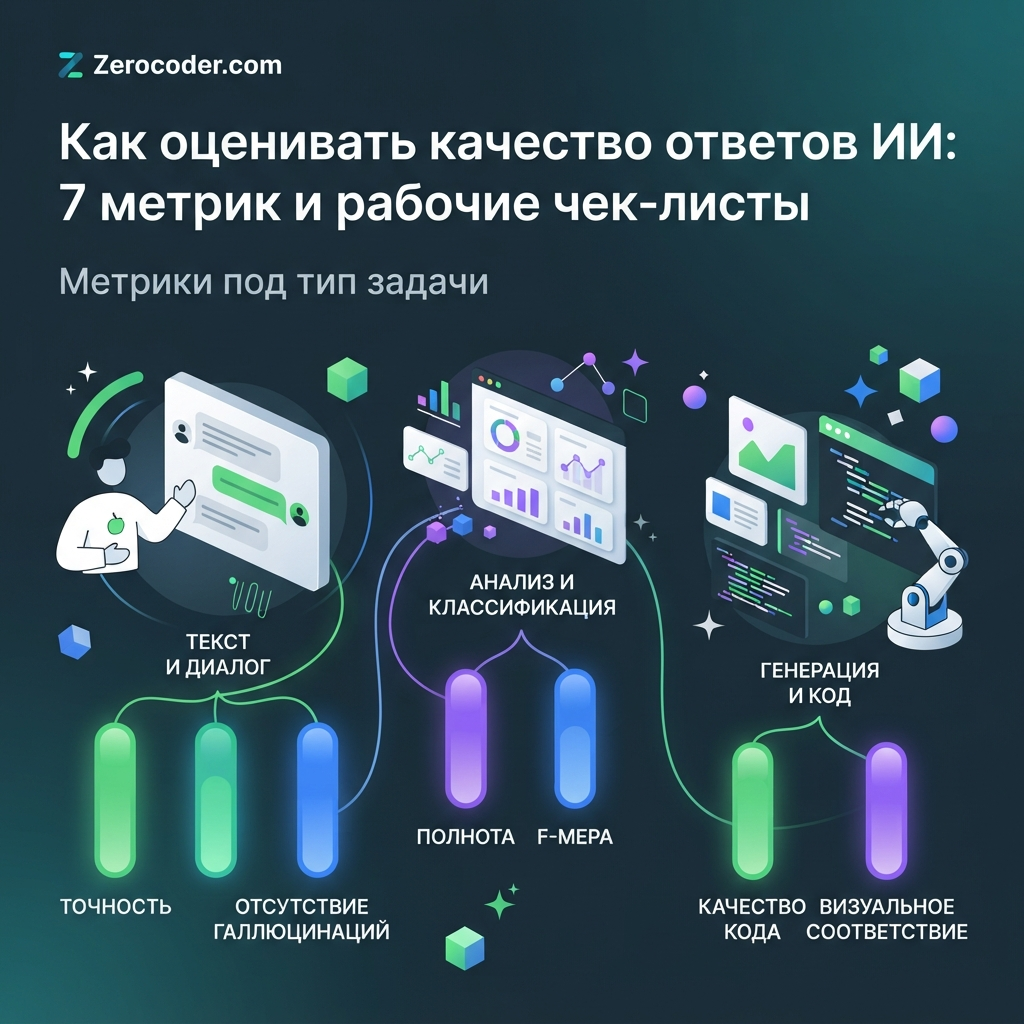
Универсальной метрики нет: для разных типов задач вес критериев смещается, и оценивать код теми же мерками, что творческий текст, неправильно. Для кода на первом месте корректность и воспроизводимость: он либо работает и проходит тесты, либо нет. Для текстов важнее релевантность, полнота и тон — фактическую точность проверяют выборочно, по ключевым утверждениям. Для аналитики критичны точность цифр и происхождение данных: одна выдуманная статистика обесценивает весь вывод. Для творческих задач жёсткого ground truth нет, поэтому опираются на структуру, соответствие брифу и субъективную экспертную оценку. Выбор модели под конкретную задачу мы разбирали отдельно — смотрите разбор выбора модели под задачу, потому что сильная в коде модель не обязательно лучшая в маркетинговых текстах. Ниже — таблица приоритетов, которую удобно держать под рукой при настройке рубрики оценки.
| Тип задачи | Главные метрики | Как проверять |
|---|---|---|
| Код | Точность, воспроизводимость | Запуск, автотесты, проверка на несуществующие методы |
| Тексты | Релевантность, полнота, тон | Сверка с брифом, выборочный фактчекинг |
| Аналитика данных | Точность цифр, источники | Ground truth, происхождение статистики |
| Творческое | Структура, соответствие брифу | Рубрика + экспертная оценка |
Для аналитических задач отдельно помогает ИИ-аналитика данных: она структурирует выводы из массива цифр, но именно потому, что речь о числах, здесь особенно строго проверяйте происхождение данных и сверяйте ключевые показатели с эталоном.
Доступ и оплата из России: на чём тестировать
Чтобы объективно сравнивать нейросети из России, важно иметь стабильный доступ к нескольким моделям без плясок с VPN и зарубежными картами — иначе часть моделей выпадет из сравнения по техническим причинам, а не по качеству. Прямой доступ к ряду сервисов из РФ ограничен, оплата иностранными картами недоступна, и это ломает саму процедуру сравнения: нельзя честно оценить модель, к которой не смог подключиться. Практичное решение — единое рабочее окно, где собраны разные нейросети, оплата идёт российскими картами, а VPN не требуется. Тогда один и тот же промпт прогоняется через несколько моделей рядом, ответы ложатся в таблицу, и вы оцениваете содержание, а не мучаетесь с доступом. Посмотреть, какие модели доступны и под какие задачи они заточены, можно в каталоге нейросетей — оттуда удобно отбирать кандидатов для своего сравнительного теста и не привязываться к одной привычной модели.
Что дальше: автоматизация оценки и приёмки
Когда ручная оценка отлажена, следующий шаг — автоматизировать рутину и встроить приёмку в командный процесс, чтобы качество проверялось системно, а не по настроению отдельного человека. Автоматизировать имеет смысл повторяемые проверки: прогон эталонных задач через несколько моделей, подсчёт баллов по рубрике, проверку формата и обязательных элементов. Творческую и фактическую экспертизу оставляют людям — полностью автоматический фактчекинг пока ненадёжен. Хороший пример автоматизированной оценки «под ключ» — ИИ-аудит сайта: он показывает, как формализованные критерии превращаются в воспроизводимый отчёт вместо субъективного «вроде норм». Для команд стоит закрепить чек-лист приёмки как обязательный этап и распределить роли: кто прогоняет, кто оценивает по рубрике, кто утверждает. Собрать этот процесс и подобрать инструменты помогают решения для команды — от общего рабочего окна до настройки единых стандартов оценки ИИ-контента внутри компании.
FAQ
Как быстро проверить ответ ИИ?
Пройдите чек-лист за 60 секунд: по теме ли ответ, нет ли сомнительных фактов, реальны ли источники, ничего ли важного не упущено, соблюдён ли формат и нет ли красных флагов вроде «удобных» процентов без источника. Если спотыкается на точности или выдуманной ссылке — переспросите модель строже или перепроверьте вручную.
Что такое галлюцинация нейросети?
Это уверенно поданный, но выдуманный факт, источник или цифра. Модель звучит убедительно, но информация не соответствует реальности: несуществующее исследование, сфабрикованная статистика, ссылка, которая не открывается. Опасность в том, что галлюцинации маскируются под достоверность, поэтому проверяйте в первую очередь конкретные детали — даты, проценты, названия и ссылки.
Какая метрика важнее всего?
Зависит от задачи. Для кода и аналитики на первом месте точность и происхождение данных, для текстов — релевантность и полнота, для творческих задач — структура и соответствие брифу. Но отсутствие галлюцинаций критично почти всегда: одна выдуманная цифра в публикации или отчёте обесценивает весь ответ.
Можно ли доверять ссылкам от ИИ?
Нет, ссылки нужно проверять. Относитесь к ним как к гипотезе: реальная ссылка открывается и содержит заявленное, выдуманная либо не работает, либо ведёт на страницу без нужного утверждения. Скопируйте название источника или цитату в поисковик — минута проверки экономит от серьёзной ошибки.
Как сравнить ChatGPT и Claude на одной задаче?
Задайте обеим моделям идентичный промпт, соберите ответы в таблицу по колонкам и оцените каждый по рубрике 0–2 балла за метрику (точность, релевантность, полнота, структура, отсутствие галлюцинаций). Сравнивайте итоговые баллы, а не первое впечатление. Удобнее делать это в едином окне, где промпт дублируется в пару кликов.
Почему один и тот же запрос даёт разные ответы?
Модели генерируют текст с элементом случайности, поэтому повторный прогон может отличаться. Если различаются формулировки, но не суть — это нормально. Если расходятся выводы (в одном «да», в другом «нет») — модель не знает ответ, а угадывает, и доверять нельзя. Для стабильности делайте промпт конкретнее и проверяйте важные выводы повторным прогоном.
Нужен ли эксперт для оценки?
Для разовых задач достаточно чек-листа и рубрики. Но если оценка качества становится системной — регулярная приёмка контента, тестирование промптов, метрики для ИИ-фичи, — разумно привлечь специалиста по промпт-инжинирингу, который выстроит рубрики и процесс под ваши задачи, чтобы команда оценивала по единым правилам.
Как оценивать код от нейросети?
Код проверяется объективнее всего: он либо работает, либо нет. Запустите его, прогоните через автотесты, проверьте на несуществующие методы и функции (частая галлюцинация). Оцените воспроизводимость на повторном прогоне и читаемость. Ground truth здесь — ожидаемый результат выполнения, с которым легко сверить фактический вывод.
Что делать, если ответ «почти верный»?
Не исправляйте вслепую — сначала укажите модели конкретную ошибку и попросите переделать только её, сохранив остальное. Если «почти» касается фактов, сверьте спорное утверждение с источником. Часто «почти верный» ответ означает размытый промпт: уточните запрос, добавьте ограничения и контекст — и качество вырастет без ручной правки.
Как настроить приёмку ИИ-контента в команде?
Закрепите чек-лист глубокой приёмки как обязательный этап перед публикацией и распределите роли: кто прогоняет задачу, кто оценивает по рубрике, кто утверждает. Заведите набор эталонных кейсов для регулярного тестирования моделей и раз в месяц пополняйте список красных флагов из пойманных ошибок. Единое рабочее окно упрощает сравнение и стандартизацию.

